Pourquoi j'ai choisi un fichier HTML plutôt que Next.js pour ma landing page
Un arbitrage d'ingénieur : choisir la bonne complexité pour le bon problème.
Il y a un anti-pattern que je vois partout dans le monde de la data : utiliser Apache Spark pour traiter 10 000 lignes de CSV. Le framework impressionne sur le papier, il est dans le CV, alors on l'utilise — même quand un simple script pandas ferait le travail en 2 secondes avec zéro infrastructure.
J'ai failli faire la même erreur en construisant ce blog. Réflexe de dev : npx create-next-app@latest loko-labs.
Un framework React, un pipeline de build, des dépendances à maintenir. Tout ça pour... afficher du texte et appeler une API.
J'ai pris du recul. Et j'ai appliqué à mon propre projet le même principe que je défends pour les pipelines de données : la bonne complexité pour le bon problème.
Ce que la landing page devait faire
Avant de choisir un outil, un ingénieur pose la question du besoin réel. Voici la spec complète :
Présenter Loko Labs et son positionnement
Afficher les derniers articles publiés sur Hashnode
Être hébergée gratuitement
Se mettre à jour automatiquement à chaque publication
Zéro maintenance dans le temps
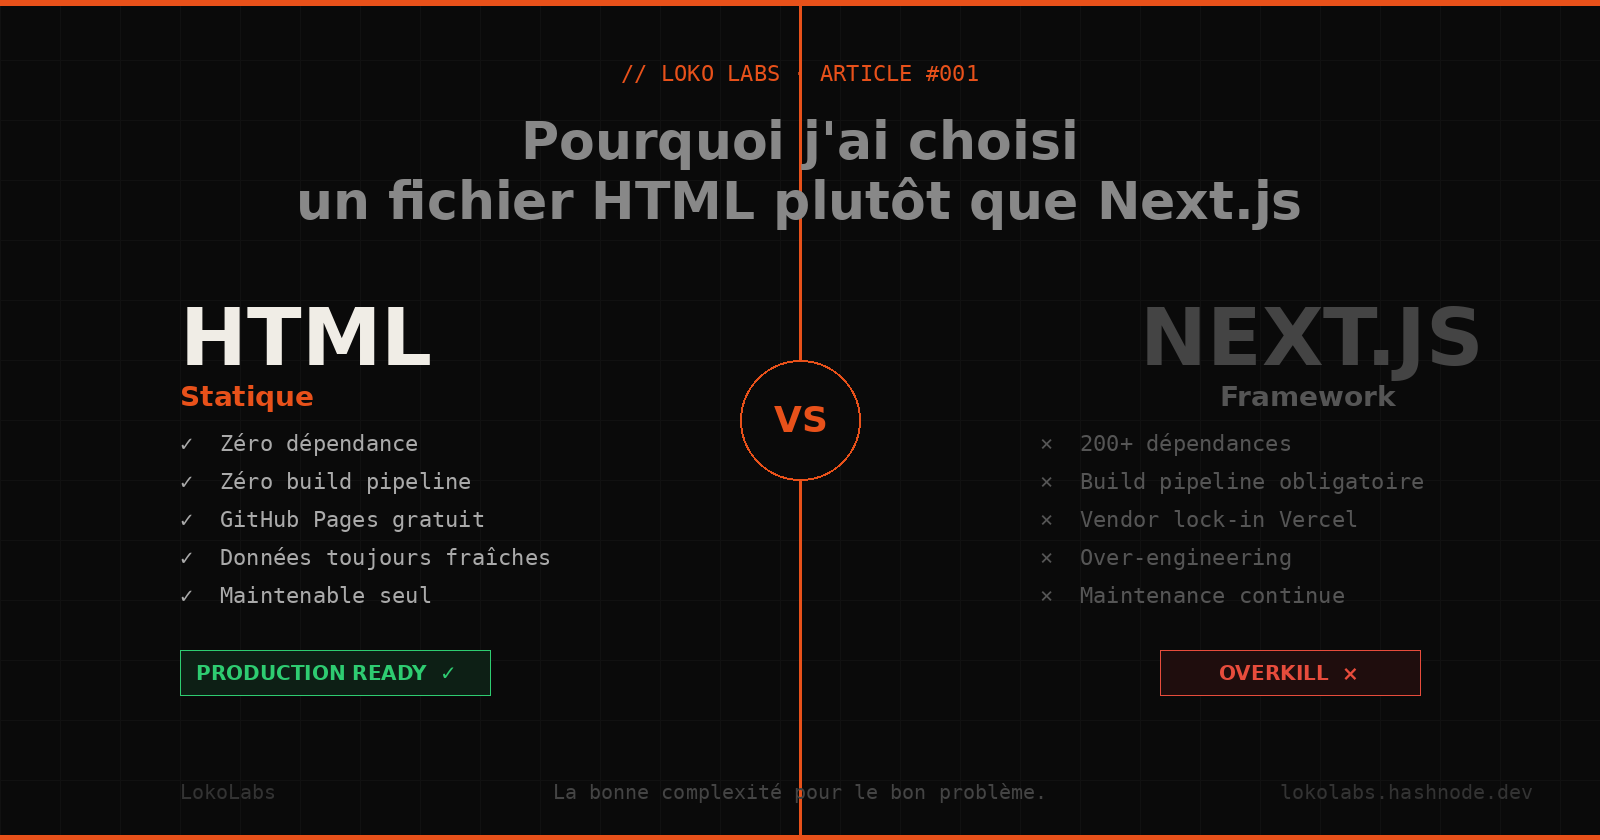
L'arbitrage : Next.js vs HTML statique
Voici les trade-offs concrets que j'ai évalués :
| Critères | Next.js/Framework | HTML Statique |
|---|---|---|
| Complexité | Build pipeline, webpack, 200+ packages | Zéro, un seul fichier |
| Dépendances | Vulnérabilités à surveiller en continu | Aucune |
| Déploiement | Vercel, CI/CD, variables d'environnement | Github Pages, drag & drop |
| Maintenance | MàJ régulières de packages | Aucune |
| Performance | Bundle JS chargé avant le 1er pixel | HTML rendu immédiatement |
| Données | SSG ou ISR à configurer | Fetch API, toujours frais |
| Portabilité | Vendor lock-in Vercel/framework | Fichier HTML portable partout |
Next.js aurait été le bon choix avec un routing complexe ou du rendu serveur. Mais pour une landing page qui appelle une API ? C'est ce qu'on appelle du over-engineering.
La stack retenue : simple, solide, portable
Voici exactement ce que j'ai utilisé - et c'est très exactement uniquement ça :
loko-labs/
    index.html    <- tout le code (HTML, CSS, JS en un seul fichier)

# Hébergement : GitHub Pages (gratuit, illimité pour les repos publics)
# Données : API GraphQL Hashnode (appelée côté client au chargement de la page)
# Domaine :  à venir, mais un fichier CNAME dans le repo suffit à le gérer
L'intégration Hashnode en 15 lignes
L'API GraphQL de Hashnode est publique. On a pas besoin de clé API pour lire les articles :
const query = `
    query {
        publication(host: "votreusername.hashnode.dev") {
            posts(first: 6) {
                edges {
                  node { title brief slug url publishedAt tags { name } }
                }
            }
        }
    }
`;

const res = await fetch('https://gql.hashnode.com/', {
  method: 'POST',
  headers: { 'Content-Type': 'application/json' },
  body: JSON.stringify({ query })
});

const { data } = await res.json();
// -> articles frais a chaque visite, sans redéploiement
Résultat : à chaque visite, les articles sont toujours à jour sans aucun redéploiement. Pas de webhook, pas de GitHub Action, juste un fetch.
Le vrai sujet : l'ingénierie, c'est choisir
Dans le monde de la data, on souffre d'un biais systématique vers la complexité. On déploie Kubernetes parce que Netflix le fait. On adopte des frameworks parce qu'ils sont populaires, pas parce qu'ils résolvent notre problème.
Un bon ingénieur data ne se demande pas "quel outil impressionnant puis-je utiliser ?" Il se demande "quel est le minimum viable pour que ça tienne en production ?"
Ce principe s'applique exactement à un pipeline de données :
Airflow pour un job cron quotidien ? → Un simple script Python suffit.
Kafka pour 100 événements/jour ? → Une table PostgreSQL avec polling suffit.
dbt pour 3 transformations simples ? → Des vues SQL directement dans la base suffisent.
Next.js pour une landing page statique ? → Un fichier HTML suffit.
La bonne stack n'est pas celle qui impressionne — c'est celle qui résiste dans le temps avec le moins d'efforts de maintenance possible.
Et la suite ?
Cette landing page va évoluer avec Loko Labs :
Domaine custom
lokolabs.dev→ un fichierCNAMEdans le repoCompteur d'articles dynamique dans le hero
Score Lighthouse target : 100/100
En résumé
La complexité est une dette.
Chaque framework, chaque service que tu ajoutes est une obligation de maintenance future. La vraie expertise d'un ingénieur, ce n'est pas de savoir utiliser les outils complexes — c'est de savoir quand ne pas les utiliser.
La landing page de Loko Labs a été construit avec un fichier HTML, l'API Hashnode, et GitHub Pages. Ça tourne, c'est gratuit, ça ne tombera pas en panne à 2h du matin. Solide comme un Loko.
Tags : #DataOps #Architecture #WebDev #Hashnode #GitHubPages #BonnesPratiques